Le OpenAI API sono uno dei modi più potenti per integrare l’intelligenza artificiale dentro software, siti web, app e processi aziendali. Non parliamo semplicemente di usare ChatGPT dal browser o tramite App, ma di collegare direttamente i modelli AI ai propri sistemi, trasformandoli in una componente stabile dell’infrastruttura digitale.
Per aziende, startup e sviluppatori questo significa poter automatizzare attività, analizzare dati testuali, generare contenuti, costruire assistenti virtuali e migliorare l’esperienza utente. L’AI smette di essere una novità e diventa una leva operativa.
Questa guida è pensata come risorsa di riferimento in italiano sulle API OpenAI, con un taglio chiaro ma tecnico quanto basta per prendere decisioni consapevoli. Quelle che seguono sono le sezioni della nostra guida:
- Cos’è OpenAI API
- Come funziona OpenAI API
- Modelli disponibili
- Costi e pricing
- Limiti tecnici
- Sicurezza API
- Casi d’uso aziendali
Cos’è OpenAI API e perché è importante per le aziende
Le OpenAI API sono interfacce che permettono a un software di comunicare con i modelli di intelligenza artificiale di OpenAI. In termini semplici, consentono a un programma di inviare richieste all’AI e ricevere risposte generate dal modello. La differenza rispetto a usare ChatGPT dal sito è sostanziale. ChatGPT è un prodotto finito. Le API sono il motore che puoi integrare dentro il tuo prodotto o servizio.
Questo permette di costruire soluzioni su misura. Ad esempio un gestionale può leggere documenti, un CRM può analizzare le email, un e-commerce può offrire assistenza automatica. Le API rendono l’AI parte del sistema, non un tool esterno.
Con le OpenAI API si possono realizzare, tra le altre cose:
- Chatbot di assistenza clienti che rispondono automaticamente alle domande più frequenti, tracciano le richieste e smistano i ticket al reparto giusto.
Esempio: un e-commerce che gestisce resi, spedizioni e stato ordini 24/7 senza operatori umani. - Sistemi di risposta automatica alle email che leggono i messaggi in arrivo e propongono o inviano risposte coerenti.
Esempio: un’agenzia viaggi che risponde in automatico a richieste su visti, documenti e preventivi. - Analisi e sintesi di documenti per ridurre il tempo di lettura.
Esempio: un manager che riceve il riassunto di un contratto di 40 pagine in 10 punti chiave. - Classificazione intelligente dei contenuti.
Esempio: un CRM che etichetta automaticamente i lead come “caldi”, “freddi” o “da ricontattare”. - Generazione di contenuti marketing su larga scala.
Esempio: descrizioni prodotto per un catalogo con migliaia di articoli. - Assistenti interni per i dipendenti.
Esempio: un bot aziendale che spiega procedure HR o policy interne. - Estrazione dati da testi o documenti.
Esempio: leggere fatture PDF ed estrarre importi, date e fornitori. - Supporto agli sviluppatori.
Esempio: suggerimenti di codice o spiegazioni di funzioni complesse.
Differenza tra ChatGPT e OpenAI API
Partiamo dalle basi per chi è completamente a digiuno di API. Molti fanno confusione tra ChatGPT e OpenAI API, ma sono due cose diverse. ChatGPT è uno strumento pensato per l’uso umano diretto: scrivi una domanda, ricevi una risposta. È ottimo per uso personale o professionale occasionale.
Le OpenAI API, invece, sono pensate per gli sviluppatori e per le aziende che vogliono integrare l’AI nei propri sistemi. Qui non c’è un’interfaccia da usare manualmente: l’intelligenza artificiale viene collegata a software, siti, app e gestionali. In altre parole ChatGPT serve alle persone, mentre le API sono a servizio dei software. Se un’azienda vuole automazione, scalabilità e integrazione nei processi, le API sono la scelta naturale.
A chi servono davvero le OpenAI API
Le OpenAI API sono utili a chiunque gestisca processi digitali ripetitivi o basati su testo. Non sono riservate alle grandi aziende. Anzi, molte PMI trovano nelle API uno strumento per fare di più con meno risorse. Sono particolarmente adatte a:
- software house
- startup digitali
- aziende con molti clienti o richieste
- team IT interni
- piattaforme SaaS
- agenzie digitali
Quando ha senso usare le API invece di tool pronti
I tool pronti sono comodi, ma hanno limiti di personalizzazione. Le API diventano la scelta giusta quando vuoi integrare l’AI nei tuoi flussi, gestisci molti utenti, stai costruendo un prodotto digitale e/o ti serve controllo sul comportamento del sistema. Se invece l’uso è sporadico o individuale, un tool pronto può bastare. Ma per progetti strutturati le API offrono molta più libertà.
Come funziona OpenAI API
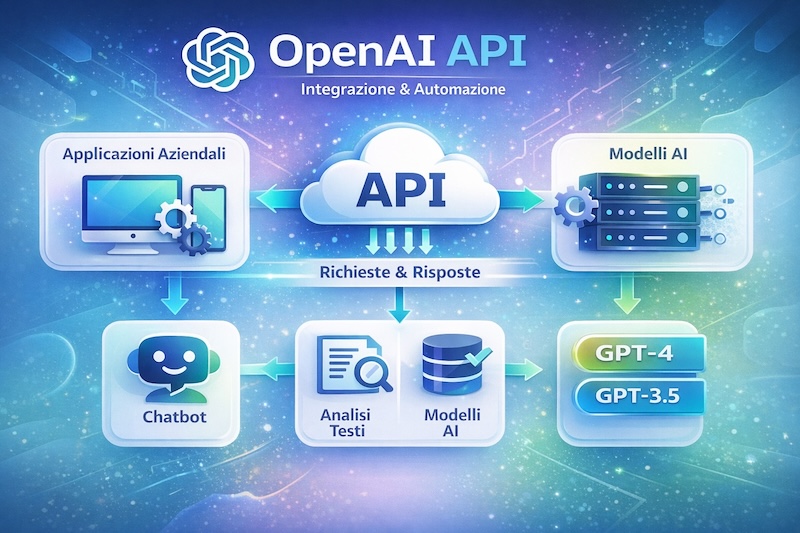
Il funzionamento dell’API di OpenAI è lineare nella logica, anche se molto sofisticato nella tecnologia. Un’applicazione invia una richiesta ai server OpenAI tramite internet. Nella richiesta inserisce testo, istruzioni o dati. Il modello elabora e restituisce una risposta.
Ogni integrazione ruota attorno a quattro elementi fondamentali: il modello scelto, l’input inviato, l’output generato e i token utilizzati. I token sono l’unità di misura del testo: servono a calcolare sia i costi sia alcuni limiti tecnici.
Non è necessario essere data scientist per usare le API, ma è importante capirne la logica. Un prompt scritto male o troppo lungo può incidere su qualità e costi. Un prompt ben progettato, invece, migliora risultati e sostenibilità.
Per questo è utile un approfondimento su come funzionano i token nelle OpenAI API >
Cos’è una chiamata API
Una chiamata API è semplicemente una richiesta che il tuo software invia ai server OpenAI. Il sistema elabora tutto e restituisce una risposta. Ma non finisce qui, perché è uno scambio continuo tra il tuo software e il modello AI: si va avanti con domanda e risposta in modo automatizzato. Dentro la tua richiesta devono esserci istruzioni, dati e contesto.
Flusso tecnico base di integrazione
Per poter costruire questo sistema di richiesta e risposta, non serve avere server AI propri. Tutta la potenza di calcolo è gestita da OpenAI. Quanto al flusso, solitamente è lineare:
- L’utente fa una richiesta
- Il tuo sistema costruisce il prompt
- Il server invia la richiesta all’API
- Riceve la risposta
- La mostra all’utente o la usa in un processo
Prompt, token e risposte: cosa significano
Prima di proseguire, è bene conoscere un po’ di terminologia e soprattutto il significato di prompt, token e risposte. Il prompt è ciò che dici al modello: istruzioni, regole, contesto. Più è chiaro, migliori saranno i risultati. I token sono le unità di testo usate per misurare l’uso. Non sono parole intere, ma frammenti di testo. Servono soprattutto per il calcolo dei costi. La risposta è l’output generato dal modello: può essere testo libero, dati strutturati, classificazioni o sintesi. Capire questi tre elementi aiuta a usare le API in modo efficace.
Quanto è complessa l’integrazione per un developer
Per uno sviluppatore con esperienza backend, l’integrazione è generalmente molt semplice. Serve sapere cosa sono chiamate HTTP, JSON e logica server-side, sempre pensando che in qualsiasi momento possiamo chiedere all’AI chiarimenti specifici o di correggere il codice. La vera sfida non è tecnica, ma progettuale: decidere come usare l’AI in modo intelligente nel prodotto che stiamo mettendo a punto.
Esempi di codice con OpenAI API
Quindi integrare le OpenAI API non è complesso per chi ha competenze di sviluppo. La logica è sempre la stessa: invii testo e ricevi testo. Su questo schema si costruiscono chatbot, generatori di contenuti, sistemi di classificazione o estrazione dati. Una chiamata tipica prevede la scelta del modello e l’invio di un input.
from openai import OpenAI
client = OpenAI()

response = client.responses.create(
    model="gpt-4.1-mini",
    input="Scrivi uno slogan per un ristorante giapponese"
)

print(response.output_text)
Per esempi concreti puoi leggere casi studio di aziende che usano OpenAI API >
Modelli disponibili e differenze
Non esiste un solo modello OpenAI, ma una gamma di modelli progettati per esigenze diverse. Alcuni privilegiano la qualità e il ragionamento complesso, altri la velocità e il basso costo. In generale si può ragionare per categorie.
I modelli più avanzati sono indicati quando serve comprensione profonda del linguaggio, analisi articolata o generazione di contenuti di alta qualità. Sono scelti spesso in applicazioni strategiche, dove l’output incide direttamente sul valore del servizio. Esistono poi modelli più leggeri ed economici, adatti a compiti ripetitivi o su larga scala. Sono utili quando servono velocità e volumi elevati, ad esempio per classificare testi o smistare richieste. Infine ci sono modelli multimodali, capaci di lavorare con testo e immagini. Trovano spazio in analisi documentali, riconoscimento visivo e sistemi che combinano più tipi di input.
La scelta del modello dipende da:
- budget disponibile
- volume di richieste previsto
- livello di qualità richiesto
- velocità di risposta necessaria
Un confronto più dettagliato lo trovi nel nostro articolo su quale modello OpenAI scegliere >
Come scegliere il modello giusto per il tuo progetto
La regola pratica è semplice: usare il modello meno costoso che risolve bene il problema. Non sempre serve il massimo della potenza, anche perché la potenza ha un costo. Spesso un modello più leggero è sufficiente e molto più sostenibile economicamente. Come detto, il modello corretto da implementare dipende da cosa devi fare.
Modelli linguistici avanzati
Sono i modelli più potenti e versatili. Offrono qualità elevata, ma hanno costi superiori. Vanno usati quando il valore generato giustifica la spesa. Vengono usati per:
- chatbot evoluti
- analisi complesse
- generazione di contenuti
- ragionamenti articolati
Modelli economici per task ripetitivi
Quando il compito è semplice e ripetitivo, i modelli leggeri sono spesso la scelta migliore. Sono più veloci e molto più economici, quindi ideali per grandi volumi. Possono essere utilizzati per:
- classificare testi
- etichettare contenuti
- estrarre dati
Modelli multimodali (testo + immagini)
Questi modelli possono interpretare immagini oltre al testo. Aprono scenari interessanti per automazioni documentali, affinché l’AI riconosca tutti gli elementi aldilà del formato in cui si trovano. Sono utili per:
- leggere documenti fotografati
- analizzare fatture
- estrarre informazioni da immagini
Costi e pricing delle OpenAI API
Il tema dei costi OpenAI API è tra i più cercati perché molte aziende temono spese imprevedibili. In realtà il sistema è piuttosto trasparente: si paga in base ai token elaborati. Ogni richiesta genera un consumo legato ai token in input e in output. Più testo viene elaborato, maggiore sarà il costo. Non esiste un canone fisso obbligatorio: il modello è pay-per-use.
Questo rende le API accessibili anche a progetti piccoli o sperimentali. Molti chatbot aziendali con volumi medi hanno costi mensili contenuti. Anche prodotti SaaS con molte chiamate API possono restare sostenibili se il valore generato è superiore al costo. Il vero punto critico non è il prezzo unitario, ma la gestione. Prompt troppo lunghi o modelli sovradimensionati fanno salire i costi inutilmente.
Situazioni tipiche:
- un chatbot interno aziendale può costare poche decine di euro al mese
- una piattaforma SaaS può scalare i costi insieme agli utenti
- una startup può iniziare con budget ridotto e crescere gradualmente
Come funziona il pricing a token
Il costo dipende dai token usati in input e in output. Più testo invii o ricevi, più paghi. Per questo la progettazione dei prompt incide direttamente sui costi.
Quanto costa un progetto piccolo, medio o grande
Indicativamente i costi dipendono dal numero totale di token usati ogni mese (input + output). Più richieste e più testo vengono elaborati, più il consumo cresce. Una classificazione pratica può essere questa:
Progetto piccolo
Circa 100.000–500.000 token/mese
Circa 20–100 €/mese
È la fascia in cui molte PMI iniziano a testare l’AI. Esempi tipici:
- chatbot per FAQ di un piccolo sito
- generazione di descrizioni prodotto per un catalogo limitato
- riassunti automatici di email interne
Progetto medio
Circa 1–5 milioni di token/mese
Circa 100–500 €/mese
Qui l’AI diventa parte operativa del business. Esempi tipici:
- chatbot clienti per e-commerce con buon traffico
- classificazione automatica di lead in un CRM
- sistema che riassume documenti o ticket di assistenza
Progetto grande
Oltre 10 milioni di token/mese
Da 1.000 €/mese in su (variabile)
In questa fascia l’AI diventa una vera infrastruttura aziendale. Esempi tipici:
- SaaS con funzionalità AI per molti utenti
- customer care automatizzato su larga scala
- analisi massiva di documenti o feedback clienti
Strategie per ridurre i costi API
Ridurre i costi è possibile con scelte intelligenti. L’ottimizzazione fa davvero la differenza, soprattutto quando si tratta di operazioni ripetitive, perché ogni singolo “spreco” si moltiplica per le richieste. Per questo è necessario, quando si parla di API, seguire alcune regole d’oro come quelle che seguono:
- prompt sintetici
- output limitati
- caching delle risposte
- modelli adeguati al compito
Allo stesso modo, ci sono errori che si pagano cari in termini economici. Molti sprechi derivano da scarsa progettazione. I più frequenti errori che fanno esplodere i costi si verificano quando:
- si inviano testi inutilmente lunghi
- si generano risposte troppo estese
- non si monitora l’uso
- si progettano male i flussi
Per chi vuole numeri concreti è utile leggere il nostro articolo Costi OpenAI API: quanto si spende davvero.
Limiti: rate limit, token e contesto
Le OpenAI API hanno limiti tecnici che è importante conoscere fin dall’inizio. Servono a garantire stabilità e uso equo delle risorse. I rate limit regolano quante richieste e quanti token possono essere usati in un certo intervallo di tempo. Nella maggior parte dei progetti standard non rappresentano un problema, ma sistemi ad alto traffico devono tenerne conto in fase di progettazione.
Un altro concetto chiave è la context window, cioè la quantità di testo che il modello può considerare in una singola richiesta. Non è memoria permanente, ma spazio di lavoro temporaneo. Se lo si supera, parti del testo possono essere ignorate o la richiesta può fallire. Per lavorare bene entro questi limiti si usano spesso le seguenti pratiche:
- suddivisione dei documenti in parti più piccoli
- recupero mirato delle informazioni rilevanti
- sistemi RAG con basi di conoscenza esterne
Quindi ogni modello ha un limite massimo di testo gestibile in una singola richiesta.
ocumenti lunghi vanno divisi e gestiti in più passaggi.
Un approfondimento su come gestire i limiti delle OpenAI API può aiutare a evitare errori progettuali >
Sicurezza e API key
La sicurezza è un aspetto critico quando si lavora con le API. La API key è una chiave di accesso: chi la possiede può usare le API a tuo nome. Questo significa che va protetta con attenzione. Non deve essere esposta nel codice pubblico o lato frontend. Deve essere conservata su server sicuri e gestita tramite variabili d’ambiente. Molte aziende si occupano di sicurezza solo dopo un problema. In realtà conviene progettare bene fin dall’inizio. Buone pratiche fondamentali sono le seguenti:
- non inserire la key in codice pubblico
- limitarne l’accesso ai soli sistemi necessari
- monitorare l’utilizzo nel tempo
- impostare limiti di spesa
Cos’è la API key e perché è critica
La API key è la chiave privata che autorizza l’uso delle API. Chi la possiede può generare costi sul tuo account. Immagina migliaia di richieste che vengono fatte da un App o un sito con cui non c’entri nulla e per ogni richiesta sei tu a pagare. E’ come dare bancomat e pin a uno sconosciuto.
Errori di sicurezza più comuni
Quando si parla di API gli errori tipici sono inserire la key nel frontend, pubblicarla su repository o condividerla tra troppi utenti. Sono rischi evitabili. In generale le azione dovrebbero sempre adottare controllo agli accessi, il monitoraggio dei consumi e un sistema di alert. Ed è bene implementare da subito una serie di best practice, di standard di sicurezza efficaci, come ad esempio i seguenti:
- uso solo lato server
- variabili d’ambiente
- rotazione periodica
- limiti di utilizzo
Per contesti professionali puoi leggere il nostro approfondimento su sicurezza API OpenAI per aziende >
Casi d’uso aziendali delle OpenAI API
Le applicazioni aziendali sono numerose e in crescita. L’AI dà il meglio quando lavora su grandi quantità di testo o su processi ripetitivi. Il valore non sta solo nell’automazione, ma nella capacità di migliorare la qualità decisionale e ridurre il lavoro manuale. Tra gli utilizzi più diffusi troviamo:
- customer care, con chatbot e smistamento automatico dei ticket. I chatbot di assistenza clienti gestiscono le FAQ, gli ordini i resi e le richieste più comuni. Ma è possibile anche automatizzare le email, perché l’AI può leggerle, classificarle e suggerire risposte.
- analisi documentale, per contratti, fatture e report. Il risparmio di tempo è notevole. Studi legali, HR e assicurazioni possono usare l’AI per sintetizzare documenti lunghi.
- marketing, per copywriting, email e contenuti SEO. L’AI supporta la creazione di testi marketing, descrizioni prodotto e varianti ADV. Non sostituisce la strategia, ma velocizza la produzione.
- business intelligence per automazioni interne aziendali, con sintesi e analisi dei feedback dei clienti. Sono strumenti che la produttività interna. Report, riassunti dei meeting e analisi dei feedback sono tra gli usi più comuni.
- formazione interna, tramite tutor e knowledge base intelligenti
Per esempi più articolati è utile leggere esempi pratici di OpenAI API >
Vuoi integrare l’AI nella tua azienda?
Integrare le OpenAI API è prima di tutto una scelta strategica. Significa capire dove l’AI genera valore, quali processi ottimizzare e come mantenere sostenibili costi e complessità.
Puoi utilizzare il nostro MegaPrompt AI Integration Planner — Progettista di Integrazioni AI per Aziende per:
- individuare opportunità reali
- stimare costi e benefici
- definire priorità
- progettare integrazioni sostenibili