Il RAG (Retrieval-Augmented Generation) con OpenAI API è il modo più concreto per far sì che l’AI smetta di “parlare in generale” e inizi a rispondere usando i tuoi documenti: PDF, manuali, contratti, policy, report. In pratica costruisci un sistema che, prima di generare una risposta, recupera i passaggi giusti dalla tua knowledge base e li usa come base per rispondere.
Se hai mai provato a “dare in pasto” un PDF a un chatbot e hai ottenuto risposte vaghe o inventate, è normale: senza RAG l’AI non ha un meccanismo affidabile per cercare, selezionare e citare (o almeno ancorare) le informazioni corrette. Il RAG nasce proprio per questo: ridurre allucinazioni, aumentare precisione e rendere i documenti aziendali “interrogabili” come se fossero un motore di ricerca intelligente, ma con risposte discorsive.
Cos’è il RAG e cosa cambia rispetto a un chatbot “normale”
Un chatbot classico risponde basandosi sul modello e su ciò che gli scrivi nel prompt. Funziona bene per spiegazioni generali, brainstorming, testi creativi. Ma appena gli chiedi “dove sta scritto nel mio manuale?” o “qual è la clausola corretta nel contratto X?”, entra in crisi: non sa davvero dove cercare e, se non trova, tende a riempire i vuoti.
Il RAG aggiunge un passaggio fondamentale: prima cerca nei tuoi contenuti, poi risponde. Quindi l’AI non parte da zero e non deve “inventare”: lavora su estratti selezionati dal tuo archivio. La conseguenza più importante è che puoi usare l’AI come assistente aziendale su documenti reali, senza dover riscrivere tutto in una nuova piattaforma o sperare che “capisca” file lunghi in un colpo solo.
Perché il RAG è perfetto per “AI su documenti PDF”
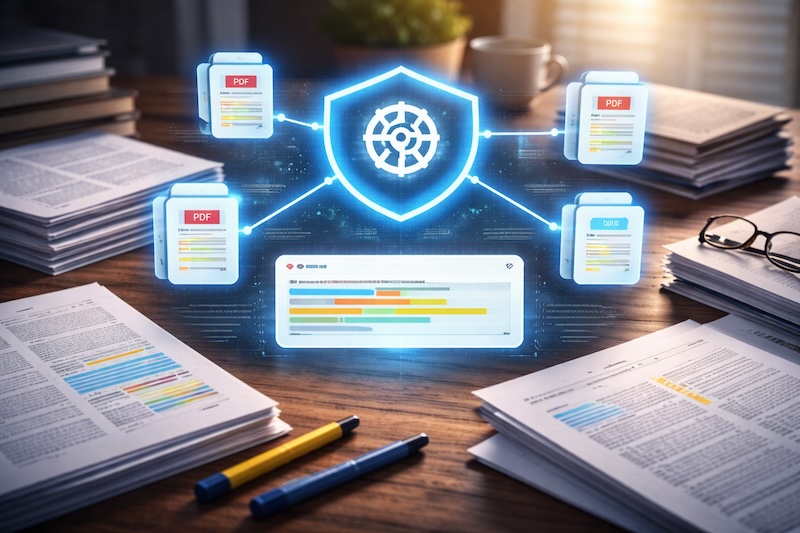
Il PDF è un formato comodo per noi, ma spesso scomodo per le macchine: layout, tabelle, note, intestazioni, pagine scansionate. Un sistema RAG ben progettato affronta questo problema con una pipeline che trasforma il PDF in contenuto utilizzabile e poi lo rende ricercabile in modo semantico.
In azienda questo è utilissimo perché la conoscenza è quasi sempre già lì, solo che è dispersa: procedure operative, FAQ interne, guide tecniche, regolamenti, listini, policy HR, contratti, compliance. Il RAG non “crea” conoscenza: la rende accessibile. E il guadagno non è solo tempo risparmiato. È anche coerenza: invece di risposte diverse da collega a collega, puoi avere un sistema che risponde in modo uniforme, basandosi sugli stessi documenti.
Come funziona un sistema RAG
Un RAG non è una singola chiamata alle API: è un flusso. Quello che conta è che ogni fase sia fatta bene, perché gli errori “a monte” si vedono subito “a valle” nelle risposte.
In generale succede questo: prendi i documenti, li trasformi in testo “pulito”, li dividi in parti sensate, crei una struttura di ricerca (di solito vettoriale) e, quando arriva una domanda, recuperi i pezzi migliori e li passi al modello per generare la risposta. La magia apparente del RAG è nel binomio recupero + generazione eseguito in modo controllato.
Fase 1: ingestione dei documenti (la qualità nasce qui)
Questa è la fase più sottovalutata. Se estrai male il testo dai PDF, se perdi titoli e sezioni, se ti porti dietro spazzatura (header ripetuti, numeri pagina, note inutili), la ricerca diventa rumorosa e l’AI risponderà peggio. Su PDF “nativi” (testo selezionabile) è più facile. Su PDF scansionati serve spesso un passaggio OCR. In ogni caso, l’obiettivo non è avere “tutto”, ma avere contenuti leggibili e strutturati: paragrafi coerenti, sezioni riconoscibili, meno duplicazioni possibili.
Poi arriva il punto chiave: il chunking, cioè la divisione del testo in blocchi. Se i chunk sono troppo lunghi, il retrieval pesca porzioni enormi e poco mirate. Se sono troppo corti, perdi contesto e la risposta diventa spezzata. Il chunking è un equilibrio tra precisione e contesto.
Fase 2: embeddings e indicizzazione (la ricerca per significato)
Una volta che i documenti sono divisi in chunk, li trasformi in embeddings: rappresentazioni numeriche che catturano il significato del testo. Questo abilita una cosa fondamentale: la ricerca non avviene solo per parole identiche, ma per somiglianza semantica.
Quando l’utente fa una domanda, fai lo stesso: crei l’embedding della domanda e cerchi nel database i chunk più simili. In questo modo, anche se nel documento non c’è la stessa frase, puoi trovare il punto giusto perché “parla della stessa cosa”. È qui che un RAG si distingue da una semplice ricerca full-text: non cerca solo keyword, cerca concetti.
Fase 3: generazione della risposta (con vincoli)
Dopo il retrieval, prendi i chunk selezionati e li passi al modello insieme alla domanda. Il modello genera la risposta usando quel contesto. Se il prompt è progettato bene, puoi ottenere risposte più prudenti e controllate: ad esempio, puoi chiedere di non inventare quando le fonti non bastano, o di segnalare che un documento non contiene la risposta.
Questa parte è spesso dove si “vince” in azienda: non ti serve una risposta brillante, ti serve una risposta affidabile, magari con rimando ai passaggi usati. Anche senza citazioni formali, puoi far sì che il sistema resti ancorato alle fonti.
Architettura tipica di un RAG aziendale (quella che regge nel tempo)
Un RAG serio non mette la API key nel client e non manda il PDF “in giro” senza controllo. Di solito c’è un backend che orchestrerà tutto: ingestione, indicizzazione, query, log, permessi. Componenti tipici sono:
- Backend che gestisce pipeline e sicurezza
- Database vettoriale (per embeddings e retrieval)
- Storage documenti (dove conservi PDF e testi estratti)
- OpenAI API per embeddings e generazione
È un’architettura modulare: puoi cambiare database o modelli senza riscrivere tutto, se hai progettato bene i confini. Inoltre è un sistema sicuro. Se vuoi saperne di più in tema di sicurezza, consulta la nostra guida su come proteggere le Api Key.
Best practice per farlo funzionare “davvero” in produzione
La maggior parte dei RAG delude”per due motivi: retrieval debole o dati sporchi. Quindi, prima ancora di parlare di modelli, conviene ragionare su qualità e controllo. Tre abitudini che fanno la differenza:
- Testare domande reali (non demo) e misurare quanto spesso il sistema recupera i chunk giusti
- Curare chunking e metadati (titolo sezione, documento, pagina, data, reparto) perché migliorano retrieval e filtri
- Gestire gli aggiornamenti: quando cambia un documento, devi sapere cosa re-indicizzare, senza rompere tutto
Quando questi aspetti sono solidi, il modello rende molto di più.
Errori comuni che fanno perdere tempo e fiducia
L’errore più comune è aspettarsi che RAG significhi caricare un PDF e nient’altro. In realtà, se non governi pipeline e retrieval, il sistema restituisce risposte mediocri e gli utenti smettono di fidarsi. Altri errori frequenti e impattanti sono i seguenti:
- chunking casuale senza criterio
- testo estratto pieno di rumore (header/footer ripetuti)
- nessun filtro per reparto/ruolo (tutti vedono tutto)
- assenza di log: non sai perché ha risposto così
In azienda, la fiducia è tutto: basta qualche risposta sbagliata e il progetto viene bollato come “non funziona”.
Quando usare il RAG e quando scegliere altro
Il RAG è perfetto quando hai tanti documenti e vuoi risposte basate su fonti interne. Se invece hai pochissimi contenuti, o se i dati cambiano in tempo reale (prezzi, stock, KPI live), potresti aver bisogno di integrazioni diverse: query su database, strumenti, funzioni, workflow.
Quindi il criterio è semplice: RAG quando la fonte è documentale e vuoi trasformarla in conoscenza interrogabile. Se la fonte è “dati vivi”, allora serve un’architettura più orientata a strumenti e query strutturate.
Il RAG con OpenAI API è uno dei pochi casi in cui l’AI diventa immediatamente utile in azienda senza dover rivoluzionare processi e strumenti. Prende la conoscenza già presente nei documenti e la rende consultabile in linguaggio naturale, con risposte discorsive e contestualizzate.
Se vuoi un sistema che funzioni davvero, la priorità non è “il modello più potente”, ma pipeline, qualità dati, retrieval e controllo. È lì che si costruisce un RAG affidabile, scalabile e adottabile dai team.
Leggi la nostra guida sulle OpenAI Api per avere una visione completa su modalità d’utilizzo, integrazioni e costi.